やりたいこと(自分用メモ)
1月ですし、本来なら2025年やりたいことというべきなんですが、とりあえず(近いうちに)やりたいこと・調べたいこと。
| Contents | Keywords |
|---|---|
| OSに関する勉強 | Linux |
| RAG関連 | RAG, Raggle, Dify, Cohere, LangChain |
| GNN | - |
| 潜在変数の取扱い | VAE, GPLVM |
| 自己教師あり学習 | Contrastive learning |
| ポケモン分析 | PokeLLMon |
| 英語 | - |
| 文章の書き方 | - |
| 強化学習 | Genesis |
| Prompt | - |
OSに関する勉強
- Windowsで仮想環境でUbuntuを扱ってるさいに、GNOME関連のエラーが多発したのですが、結局解決できなかった。いまは仮想環境を使ってないので、必須じゃないが、以下が良書の予感なので。https://operating-system-in-1000-lines.vercel.app/

RAG関連
- 去年、Difyをさわってみて、使いやすそうなんだが、思ったよりも複数回使いたいような問題が思ったより思いつかない。資料の数が少なければ、GoogleのNotebookLMで現状十分。ただ何に使えるか考えたいので、おさえておきたい。https://cloud.dify.ai/
GNN
- テーブルでも時系列でも画像でもない、ということで仕事にも使えそうなので、概要はおさえておきたい
- Graph neural network - Wikipedia
潜在変数の取扱い
- 今まで教師なし学習は、何に使えるのかわかってなかった。年末にFoundation model for timeseries dataから、
- のように繋がってきた。GPRやEncoder-Decoderモデルは仕事でさわる機会があったのに、全然わかってなかったんだなと反省し、勉強中。
自己教師あり学習
- 上と関連して、とくに画像関連で深層学習の変遷や工夫が面白く、ためになりそう。とくにContrastive learningはちょっとなに言っているか理解できなかったので、実装して確認したい。
- Full Guide to Contrastive Learning | Encord
ポケモン分析
- 昨年までポケモン分析しようとしていたが、これ以上やるには詳細な技やステータス振りを考えるのが必要に感じていた。が、それをやるには
- で、難しそうだなーと思っていた(それで代わりに競艇でも考えてみようといろいろやったが、結局競艇に興味をもでずそのまま)。
- そんなときに以下があって、心が揺れている。PokeLLMon. [2402.01118] PokeLLMon: A Human-Parity Agent for Pokemon Battles with Large Language Models
- が、Pokémon Showdown! battle simulatorは公式じゃないし、結局やらないかなー。
英語
- 英語はとくにListeningに苦手意識がある。NHK英語ラジオはかなりよいのだが、頑張って続けたい。
- 英語のテレビ番組・ラジオ番組 | NHKゴガク
- TOEICなどのようにテストを受けずにしかもピンポイントで苦手な項目がわかる方法がしりたい。
- 読書速度の測定・読書スピード計測|英語総合読解力測定メジャーさんの大学入試用でこないだ170だったのだが、ネイティブは300程度らしいので、間を取って250あたりを目指したい。
- ついでにボキャブラリーも2万くらいに増やしたい。

文章の書き方
- Introでの既往研究の参照がやっと腑に落ちた。うまく書けるようになりたいなー。
- アートとしての論文 人文系の院生が査読を通すためのドリル - Write off the grid.

強化学習
- Genesis。GitHub - Genesis-Embodied-AI/Genesis: A generative world for general-purpose robotics & embodied AI learning.
- 現実の43万倍は条件次第だろうし、そもそも並列計算してるし、で話半分に聞いておきたいが、共通のプラットフォームができるのはいい流れなので、もう少しドキュメントがしっかりしたら読んでおきたい。
- MPM, GitHub - zhouxian/FluidLab: [ICLR 2023] FluidLab: A Differentiable Environment for Benchmarking Complex Fluid Manipulation
- SPH, GitHub - erizmr/SPH_Taichi: A high-performance implementation of SPH in Taichi.
Prompt
- 現状困っていないので、モチベーション低いが、、、
- Day 1 - Prompting | Kaggle
Chronos (amazon)にさわってみる
先日は色々な方法のTimeseries推定法を試してみましたが、Foundation model for timeseries dataは手元の弱小PCだと動かすのは難しいかな?とあきらめてました。
が、どうも最近のは無料でもサービスが行き届いているようで、例えばAmazonのChronosだと https://huggingface.co/amazon/chronos-t5-tiny tiny => mini => small => base => large とサイズが5段階に分かれていて、ワンチャンできるかな?と思ったので、試してみました。
Chronosの概要
Foundation model for timeseries dataはChronos以外にも複数ありますが、Hugging face内で2024年末時点では一番ダウンロードされているとのこと。
と、どうやらChronosは標準で確率分布を返すらしく、それも気になったのでChronosとしました。更にそのなかでzero-shotでの性能に優れるらしいChronos-bolt-tinyとやらもあるので、両方を使います。
さわった感じ、CPU onlyでもさくさく動きます。
確率分布出力
幸か不幸か、minimal exampleでAirplane passengersを扱っていたので、ほとんどそのままでいけましたが、確率分布のところがよくわかりませんでした。
標準で、pipeline.predict_quantiles()ができるのですが、codeをよく読むとprediction_samplesを出力して、そのtorch.quantile()を出しているだけのようです。小さいquantile_levelsで実行すると、下記警告がでます。
Quantiles to be predicted ([0.025, 0.5, 0.975]) are not within the range of quantiles that Chronos-Bolt was trained on ([0.1, 0.2, 0.3, 0.4, 0.5, 0.6, 0.7, 0.8, 0.9]). Quantile predictions will be set to the minimum/maximum levels at which Chronos-Bolt was trained on. This may significantly affect the quality of the predictions.
pipeline.predict_quantiles()は内部でpipeline.predict()をおこなっていて標準で20サンプルなので、その程度を想定しているのでしょう。
無理やり、1ステップのみ予測して、1~99%quantileを出力すると、図のようになります。

参考に、16,84%の出力の差を2sigmaにして、mu=50%で正規分布を無理やり描きました。そもそも外側に裾が広いので、正規分布よりも対数正規分布他のほうがフィットしそうですが、簡単のためそのまま。
もとの線はやけにカクカクしながらも、まー許容範囲くらいな感覚ですが、確かに10-90%から外れると明かに不自然な曲線になってますね。
当初、predict_quantiles()があったので、predict()で確率的に出るのは、quantile回帰していると想像していました(例えば、0-1の一様分布で20個サンプルを生成して、それに該当するquantileを返す)。ところが、どうも生成モデルのトークンのランダム性のよう。直接値を推定しているんじゃなく、入力をトークン化してその生成確率を推定しているのか、理解が追い付かない。predict()の引数にも関係するパラメータがあります。
- temperature: Temperature to use for generating sample tokens.
- top_k: Top-k parameter to use for generating sample tokens.
- top_p: Top-p parameter to use for generating sample tokens.
temperatureを変化させて、quantilesに与える影響を確認します。

予想したとおり、小さいtemperatureでは変化はほとんどなく、標準(1.0)ではそれっぽい形。なお、中央値もずれてるのはサンプルから出してるからだと思いますが、けっこうずれてますね。
以下ではtemperatureはいじらずに生成して、mu±2sigmaを95%区間としましたが、詳細な区間が欲しい場合はpredict_quantiles()を使わずに直接predict(num_samples)として自分で求めたほうがよさそうな気がします。
結果(zeroshot=Finetuningなし)
ということで、16,50,84%から2sigmaに無理やり外挿した範囲を示します。
なお、出力は一気に48stepとします(前回は1stepを繰り返したが、、、)
Chronos-tiny

Chronos-bolt-tiny

...。いや、Chronos-tinyはまーzeroshotならこんなもんか、くらいのイメージですが、boltのほうはまじでzeroshotでここまで一致させてくるか?という感じです。
落ち着いてみると、ちょっと各年のピークの推定範囲が狭い気がするし、 確かに、各年のsigmaで残差を割ると、それは確認できます。
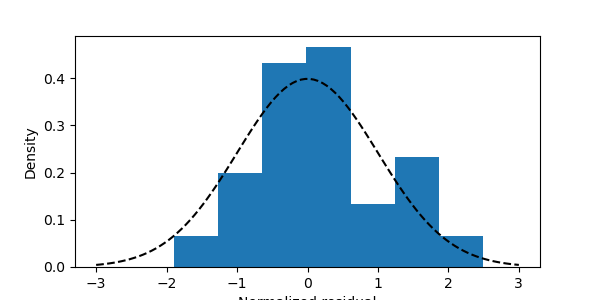
が、これがzeroshotでかつtiny-modelということにショックが大きすぎます。本来なら、下記を参考にFine-tuningしたかったのですが、
たぶんやっても明確にわかるような差はでない気がするので、省略します。
さいごに
なにより、これが全くのzeroshotでできるのが驚きです。*1確かにAirplane passengersは周期性がわかりやすく、簡単なタスクだとは思いますが、それでもGPやARでやるならどんなモデルにするか考える必要があるところ、まさしく入れてポンででてくる。
ちょうど以下のまとめを見ていたので、こりゃ仕事なくなるわと笑いました。
Foundation modelがどんなことに使えるか、ちょっと真面目に考える必要がありそうです。
時系列データ分析(GP,RNN,BNN(AR),LLM4TS,FM4TSなどなど)
概要
時系列データ分析の練習です。 年末Foundation model for timeseries なるものを知って調べてる最中ですが、とりあえず手を動かしてみないと思ったので、いろいろ比較検討します。
データ
使うデータは時系列データといえばの、Airline passengersです。 下はKaggleのHPですが、いろんなパッケージに入ってます(seabornとか)。
ARIMA
時系列といえば、ARIMAです。 トレンドや季節項を分けて考えるので、説明性が高くわかりやすいです。
実装例はたくさんあるので、省略します。
Air Passengers- Time Series- ARIMA | Kaggle
GP (Gaussian Process)
ガウス過程。

理論的には困難ですが、こちらも説明性が高いです。ARIMAと異なり、等間隔のデータである必要がないので、時系列以外もに広く適用可能です。
PythonではGPyが圧倒的に使いやすいです。 以下が非常にわかりやすいです。
GPy(Pythonのガウス過程用ライブラリ)の使い方 - StatModeling Memorandum
ガウス過程のAirline passengersへの適用例は、以下にあります。
Covariance Functions and Hyperparameter Optimization
こちらでは直接GPを適用してますが、Airline passengersは指数関数的な変化をしてるので、logに対しGPを適用します。

kernel = GPy.kern.Bias(1, variance=30) + \
         GPy.kern.Matern32(1, lengthscale=20, variance=0.1) + \
         GPy.kern.PeriodicMatern52(1, variance=1, lengthscale=2, period=1)

model = GPy.models.GPRegression(x, np.log(y), kernel)
model["sum.bias.variance"].constrain_fixed(30)
model["sum.periodic_Matern52.period"].constrain_fixed(1)
Test区間で推定値は実際よりも下にいきますが、これはバイアス項をかなり大きくしているためです。ただし、95%内には入っており、少なくともCI区間は感覚的にはいい感じと思ってます。
まだ腑に落ちていない点としては、モデルの決定方法。例えばconstrain_fixedせずにパラメータをoptimizeすると、bias.varianceはもっと小さくなります。それがそんなに悪いか?と言われるとちょっと気持ち悪い程度でうまく答えれられないのですが、理由がわからないのが気持ち悪い点でしょうか。
線形に増加するのだから、kern.Liniar()を使えば?とも思いますが、線形の仮定がめちゃめちゃつよく、外挿の際に分散が減少しないのが気持ち悪い。
他にも複数のkern.ExpQuadCosine(1)の重ね合わせで表現する際に、その数をAICで決定しようとすると、手元の環境では7つになりました。一方で、せいぜい3つぐらいから感覚的にはほとんどかわらないので、モデル選択が難しいですね。
RNN
やっとNNです。当然、RNNの実装例は多く、以下などがあります。
https://www.kaggle.com/code/xcwang21/flights-passenger-dataset-with-rnn-lstm-prophet
https://github.com/abhiupes01/Multi_Step_Time_Series/blob/master/RNN_flight_passanger.ipynb
が、1個目だと一見よく推定できているように見えますが、2個目で指摘しているように、Multi_stepで推定したときに全く推定できていません。直前のデータをそのまま返すだけになってますね。1個目でうまくできてそうに見えるのも、単純に入力を1ステップシフトしただけなんでしょう。
学習がうまくいっていないのはデータ数のせいなのか。そもそもAirplane passengersが高々120程度のデータ量で、RNNを使うのがどうかしてるのか。合成データをつくるのも一案ですが、とりあえず保留しています。
BNN(AR)
次にベイズ深層学習です。

実はこの本は3年前には購入していたのですが、なかなか難しく長い間放置されていました。
本来ならSimpleRNNか、LSTMを使いたかったのですが、先のとおり通常のRNNでうまく行っていないので、単純なAR(自己回帰モデル)を用います。 AR(auto regression)はその名のとおり、過去の自身の線形和で表されるので、単純なLinear層のみで表せます。例えば、過去12個まで見るなら、+bias項の計13個のパラメータと、RNNよりも圧倒的にパラメータ数が少なくて済みます。
BNNに話を戻して、本はとりあえず置いたままにして、結局他のブログ等を参考にBNNを理解しようとしました。そして今回やっと気づいたこと。
- パラメータの事後分布は自由ではなく、基本的には正規分布とするよう。つまり変分ベイズ。パラメータ数は単純な2倍ですむ。
- BNNは推定+分散推定ではない => サンプルを出力するので、それから信用区間を算出(たぶんMCMCと同じような感じ)
- パラメータの事前分布は一様ではなく、これも正規分布が基本のよう。
今回のような単純なNNなら分散の出力が可能だろうが、例えば活性化関数が入ったらそれだけで困難な気がする。なので思ったよりはBNN難しくないかも。
そもそもARのフィットがよかったのもあるが、信用区間にもそれっぽさがあります。

なお、BNNで検索すると、pyroとやらがたくさん出てきます。
Simple Bayesian Neural Network in Pyro | Kaggle
が、以下のように単純にpytorchのみで記述できそうで、なにが簡略化できるのかよくわかっていません。要勉強。
code example
class BayesianLinear(nn.Module):
    def __init__(self, in_features, out_features):
        super().__init__()
        self.mu = nn.Parameter(torch.Tensor(out_features, in_features))
        self.rho = nn.Parameter(torch.Tensor(out_features, in_features))
        self.bias_mu = nn.Parameter(torch.Tensor(out_features))
        self.bias_rho = nn.Parameter(torch.Tensor(out_features))
        self.reset_parameters()

    def reset_parameters(self):
        nn.init.kaiming_uniform_(self.mu)
        nn.init.constant_(self.rho, -3.0) # 初期値は小さめに設定

    def forward(self, x):
        sigma = torch.log1p(torch.exp(self.rho))
        weight = self.mu + sigma * torch.randn_like(self.mu) # 重みをサンプリング
        bias = self.bias_mu + torch.log1p(torch.exp(self.bias_rho)) * torch.randn_like(self.bias_mu) # biasをサンプリング
        return nn.functional.linear(x, weight, bias)

    def kl_loss(self,sig=3):
        mu_prior = torch.zeros_like(self.mu)
        sigma_prior = sig*torch.ones_like(self.mu)
        p = dist.Normal(mu_prior, sigma_prior)
        q = dist.Normal(self.mu, torch.log1p(torch.exp(self.rho)))
        kl_weight = dist.kl_divergence(q, p).sum()

        mu_prior = torch.zeros_like(self.bias_mu)
        sigma_prior = sig*torch.ones_like(self.bias_mu)
        p = dist.Normal(mu_prior, sigma_prior)
        q = dist.Normal(self.bias_mu, torch.log1p(torch.exp(self.bias_rho)))
        kl_bias = dist.kl_divergence(q, p).sum()
        return kl_weight + kl_bias
LLM4TS
最近急激に身近になったLLMですが、これを時系列データに適用しようというもの。「いや、そんな簡単にできねーだろ」と思ったのですが、強化学習への適用例もあるので*1、なんでもありなのかな。
それでpromptのみでできるものもあるらしいので、試しに。
Prompt1
Here is some values for each month. Without using codes, Estimate the value over the 48 months following this.

37,  39,  44,  43,  40,  45,  49,  49,  45,  39,  34,  39,
38,  42,  47,  45,  41,  49,  56,  56,  52,  44,  38,  46,
...略
80,  77,  89,  89,  90, 105, 121, 115, 104,  91,  79,  92,
94,  92, 105, 104, 106, 124, 137, 135, 118, 102,  90, 102
Output
To estimate the values over the next 48 months based on the given data, I’ll assume the following:

Seasonality: There is a repeating seasonal pattern in the data, evident from the oscillations over months.
Trend: There is an upward trend over time, as the values generally increase across the years.
Here’s how the estimate can be constructed:

Decompose the data into trend and seasonality:

The trend increases roughly linearly, with some fluctuations. From the first year (37–49 range) to the last year (92–137 range), the trend grows by approximately 10–15 units per year.
The seasonality appears to repeat every 12 months with highs around mid-year and lows toward the end or start of the year.
Project the trend:

If the current year ends around a trend of ~120, the next year might start around 125 and increase to ~135 by year-end. This continues with an approximate 10–15 unit annual increase.
Add seasonal adjustments:

Seasonal variations are around ±10 to ±15 units from the trend.
Estimated Values (48 Months)
Year 1 (Months 1–12):
Trend grows from 125 to 135, adjusted seasonally:
126, 128, 134, 133, 130, 138, 144, 144, 139, 133, 125, 132

Year 2 (Months 13–24):
Trend grows from 135 to 145, adjusted seasonally:
136, 138, 144, 143, 140, 148, 154, 154, 149, 143, 135, 142

Year 3 (Months 25–36):
Trend grows from 145 to 155, adjusted seasonally:
146, 148, 154, 153, 150, 158, 164, 164, 159, 153, 145, 152

Year 4 (Months 37–48):
Trend grows from 155 to 165, adjusted seasonally:
156, 158, 164, 163, 160, 168, 174, 174, 169, 163, 155, 162

This projection reflects the combination of a consistent upward trend and repeating seasonal patterns over the next 48 months.
Prompt2
Estimate with additional 95% confidence intervals.
Output2
To estimate the 95% confidence intervals, we account for variability in the data around the trend and seasonality. Based on the provided values, here are the steps:

Steps for Adding Confidence Intervals
Calculate Variability:

The given data shows variability around the trend and seasonality. The deviation from the trend appears to range between ±5 and ±15 units.
Assume Normal Distribution:

A 95% confidence interval implies the range within approximately ±2 standard deviations from the mean. For simplicity, we can assume the variability (standard deviation) is about ±10 units, based on the observed fluctuations.
Confidence Interval Range:

For each estimated value, add and subtract 20 units (2 × 10 = 20) to establish the 95% confidence bounds.
Revised Estimates with Confidence Intervals
Year 1 (Months 1–12):

Month   Estimated Value Confidence Interval (±20)
1   126 106 to 146
2   128 108 to 148
3   134 114 to 154
4   133 113 to 153
5   130 110 to 150
6   138 118 to 158
7   144 124 to 164
8   144 124 to 164
9   139 119 to 159
10  133 113 to 153
11  125 105 to 145
12  132 112 to 152
Year 2 (Months 13–24):

Month   Estimated Value Confidence Interval (±20)
1   136 116 to 156
2   138 118 to 158
3   144 124 to 164
4   143 123 to 163
5   140 120 to 160
6   148 128 to 168
7   154 134 to 174
8   154 134 to 174
9   149 129 to 169
10  143 123 to 163
11  135 115 to 155
12  142 122 to 162
Year 3 (Months 25–36):

Month   Estimated Value Confidence Interval (±20)
1   146 126 to 166
2   148 128 to 168
3   154 134 to 174
4   153 133 to 173
5   150 130 to 170
6   158 138 to 178
7   164 144 to 184
8   164 144 to 184
9   159 139 to 179
10  153 133 to 173
11  145 125 to 165
12  152 132 to 172
Year 4 (Months 37–48):

Month   Estimated Value Confidence Interval (±20)
1   156 136 to 176
2   158 138 to 178
3   164 144 to 184
4   163 143 to 183
5   160 140 to 180
6   168 148 to 188
7   174 154 to 194
8   174 154 to 194
9   169 149 to 189
10  163 143 to 183
11  155 135 to 175
12  162 142 to 182
Summary
The estimated values include confidence intervals of ±20 units to account for seasonal and random variations, providing a more realistic range for the projections.
なお、当初Airplane passengersと具体的に書いていたところ、年は書いてないにもかかわらず、それを補ってアウトプットしだしたので、それらの文言を除いて、かつ具体的な数字からも類推されるかと思ったので元の数字を3で割った整数にして、入力しました。
また、まるで"Step by step"と入力したかのように、分析して結果ARIMAがよいと判断して、コードを書きだすことが多かったので、"Without code"を追加しています。とくに最近Reasoningがうまくなっているので、もしかするとGPT3.0などと古いほうがうまくいくのでは?と思っています。*2
何回か試して奇跡的にそれっぽい(つまり適当に)推定してきましたが、結果は推定については悪くはないがよくもない、推定区間は単純な±一定の適当な感じでした。

紹介例は自然言語も兼ねた適用例な一方、今回のは本当に単純なTimeseriesデータだったので、かえってうまくいかないのか。
もう少し実施例が広まったら、再度試してみたい。
FM4TS
Foundation Model for TimeSeries data.
上では、GoogleのTimesFMを他の手法(ARIMAやGP)と比較しています。
Airplane passengersでは両者にはおよばないものの、他の多くの課題で1-3番目くらいのできで汎用性がある、とのこと。
前に示したとおり、RNNのうまくいかない原因の一つがデータ不足だとしたら、Pre-trainedのFoundation modelは解決策になるのも納得できるところ。
近いうちにやりたい。
まとめ
時系列データに対して複数の対応方法がある。従来法としてARIMAやGPがあり、いまでもそれらはトップクラスの性能だが、適切なモデル選択が必要。一方、自然言語につづき、Foundation modelができるとその適用が期待できるし、そもそもそういった自由度の高さがNNの魅力のひとつだと思う。
ついでに推定の際に、その推定範囲も示すことが実用上必要なことが多々ある。そのうえでBNNは強力な手法になりそう。Foundation modelも最後の出力層か+αのみベイズ的にすれば変わらずできるのだろうか?
*1:https://qiita.com/pocokhc/items/44a8643e9570efb61a48
*2:が、とりあえずチャットベースですぐに確認できる、ChatGPT, Gemini, Claude, Mistralで試したところ、どれも明確な違いはなさそう
データでみるボートレース(試し)
少しポケモンから離れて、ボートレース面白いなーと最近思い始めました。それで色々調べ始めたんですが、データがめちゃくちゃそろってるんですが、レース場や選手・コース、さらに天気や一緒に走る選手から見てみます。 ちなみに私のボート知識は、「モンキーターン」と、ここ1か月程度ボート関連のYoutubeをあさってた程度です。
登録期
ボートは年2回ごと30人ほど、新しいレーサーが追加されます。
SG、G1、G2、G3、一般および合計に対する出走経験がある選手の数を図にします。現在の期から登録期を引いて、2で割った値を経験年とします。 なお、70期より前は出走数が少ないので、その頃より前の時期のデータが少ない可能性があります。
 艇国データバンク - ボートレースの総合データベースサイトから(2024/9/15調べ)
- SGは早くて5年。*1
- SGは各期10人くらい。
- G1は各期20人くらい。
次は全体勝率。点線は各期の選手の中央値です。

通算勝率は、20年くらいで最大になります。ってことは単期の成績は、これ以降は下がっていって、カーブ的に10-20年選手くらいがもっともよさそうですね。
サイトによって違いますが、だいたいどこも35-45歳くらいがピークといってるので、一致してそうですね。*2
とすると、はじめ10年程度の選手に対して前年データを使うのは、注意が必要そうですね。
レース場
レース場ごとの違いは、モンキーターンの読みどころのひとつです。例えば、海水・淡水の違い、コース幅や川の流れ、ナイター...
で、疑問に思ったのは、選手はそのレース場になれるまでに時間がかかるのか?
まず、選手は初めは地元のレース場が多く、その後地方のレース場にも呼ばれるようなるようです。4,5年たつと全24レース場に参加経験があるようになります。
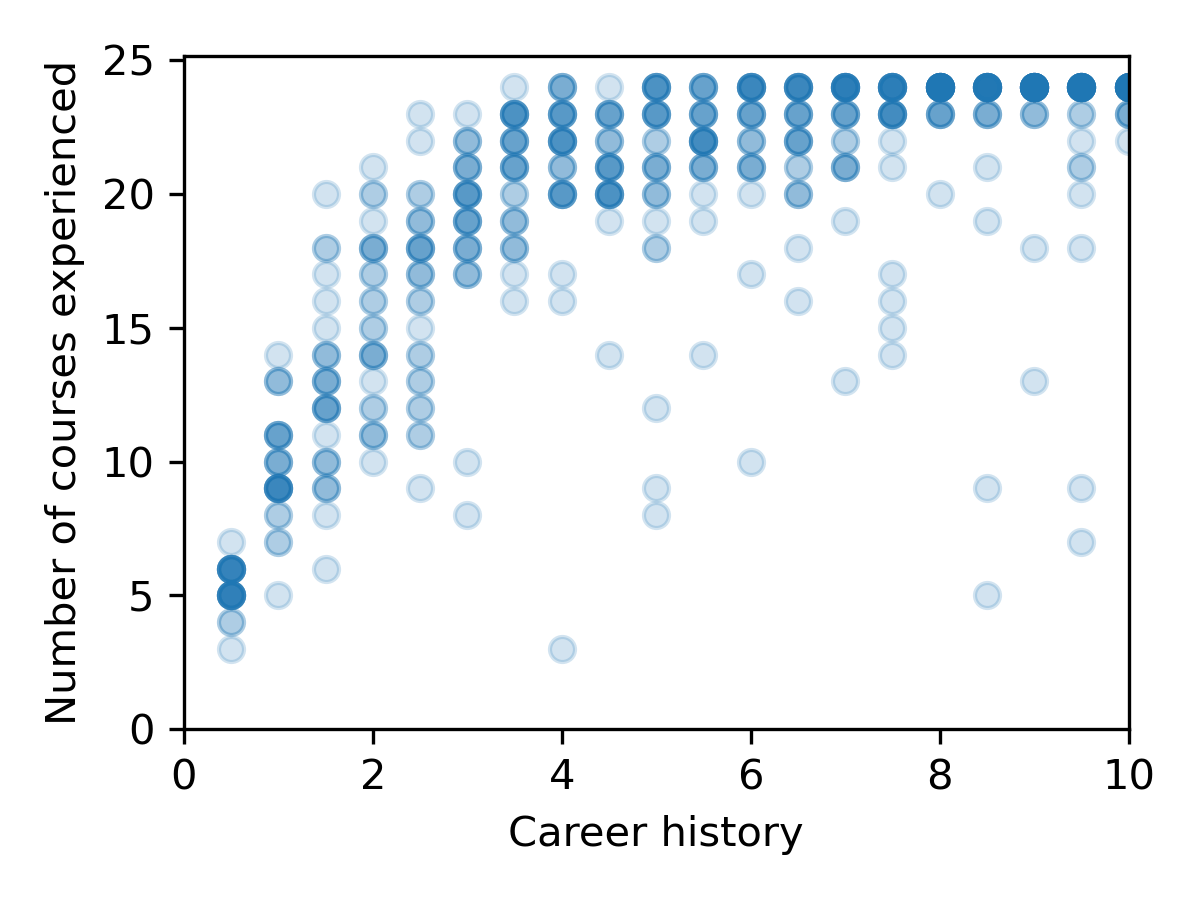
で、肝心の得意なレース場については、単純にレース場ごとの勝率の標準偏差を経歴で整理します。
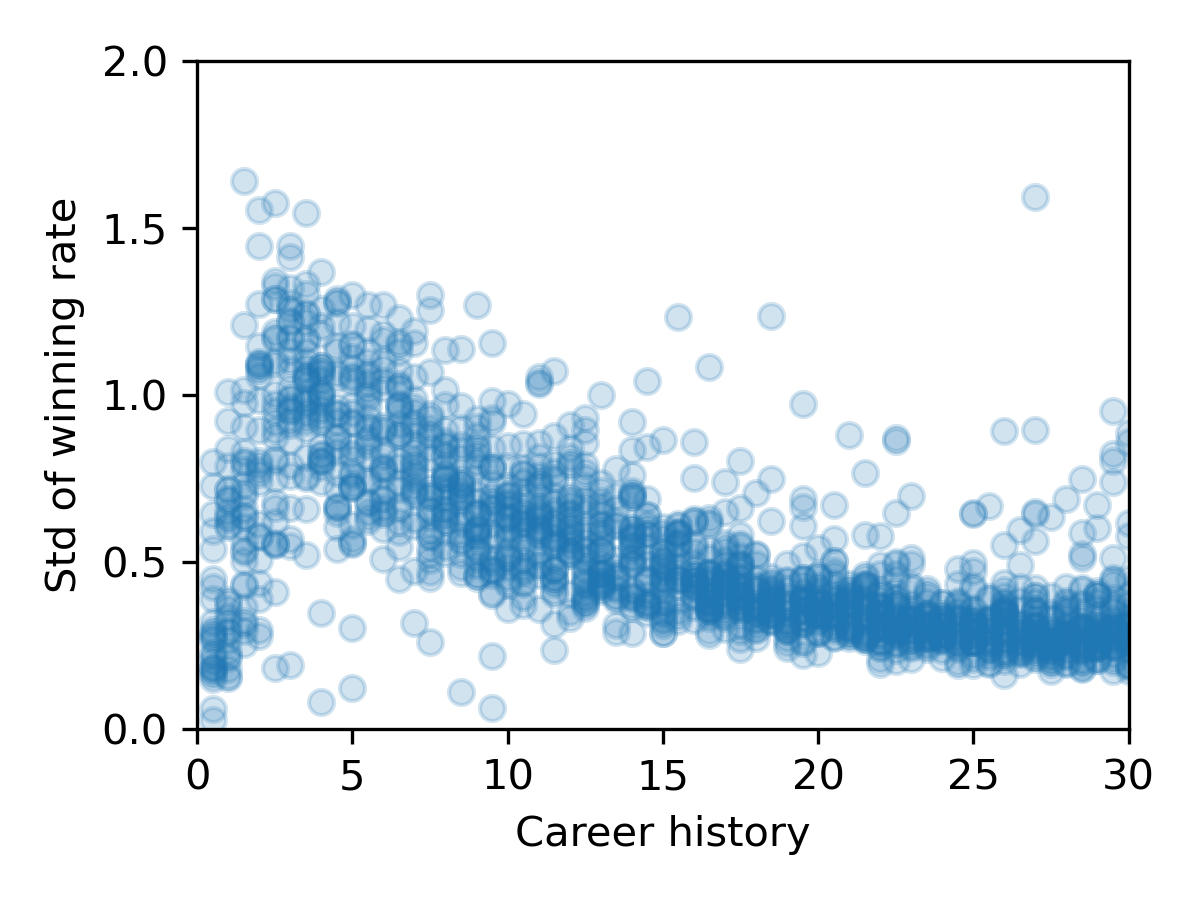
2年までは、参加レース場が少ないせいか、ばらつき自体が少ないですが、それ以降は経験年数によって、レース場ごとの勝率のばらつきが小さくなっていきます。
同様の結果は、スタートタイム(ST)についても言え、勝率は25年、スタートタイムは15年、程度が安定するまでにかかります。
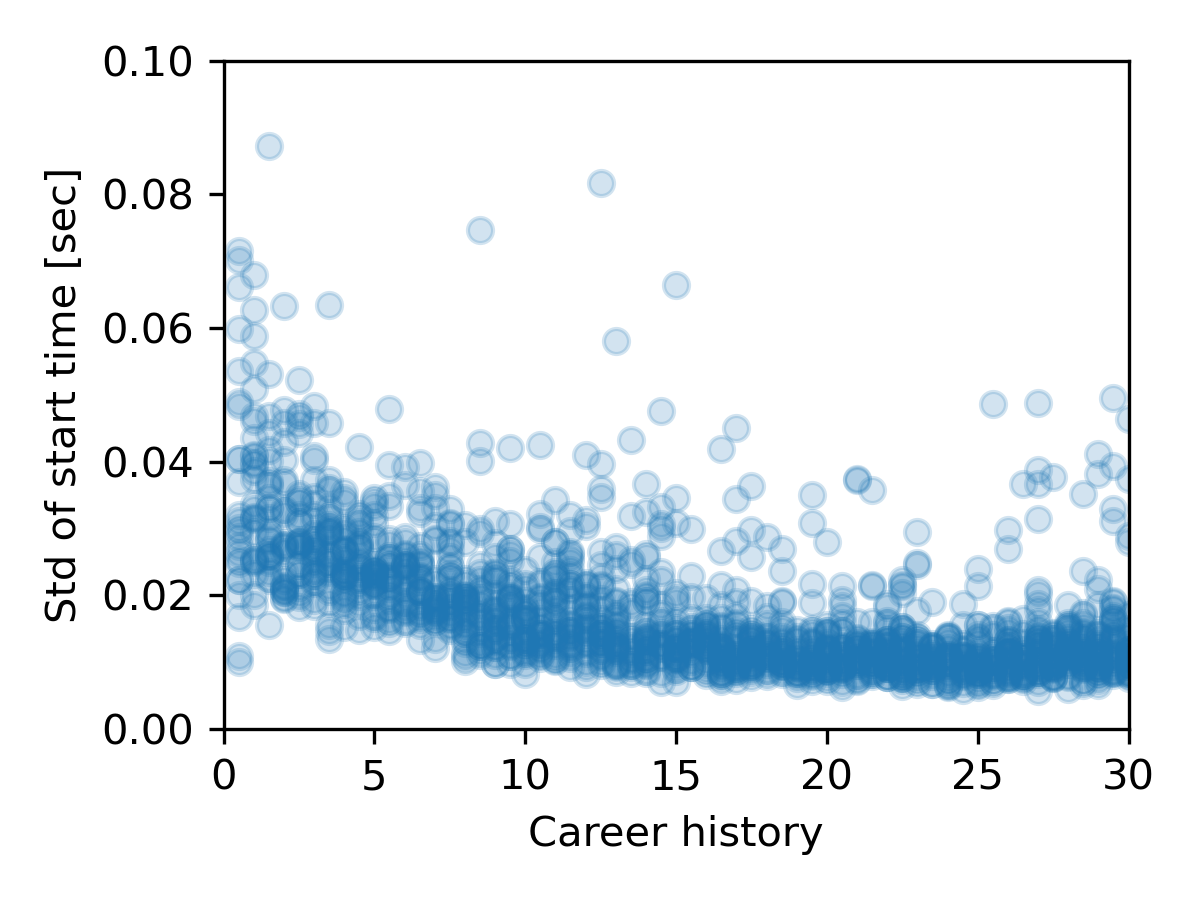
ということは、経歴15年以内なら、全国の情報より、ローカルの情報が有効そうです。
オッズ
単勝、複勝、2連単、2連複、拡連複、3連単、3連複、それぞれの配当オッズ。
点線は、理論的な的中率の逆数(例えば単勝の的中率は1/6)。
マーカーは、平均的な配当のオッズ。
 (2022年。
BOAT RACE Today's Race Information Index
から。)
当たり前ですが、オッズは理論的な的中率よりも6-7割くらい小さい。 競艇の還元率は75%*3なので、それよりも更に低いです。おそらく、返還金を考えていないせいでしょうか?だとすると、単勝で平均的な配当が理論的な値に一番近いのも、納得できます。
対数をもとに、累積を通常に戻すと、

実線はOddsの逆数、破線はさらにそれの0.5倍。
例えば、Odds10倍が1/10以上の確率で当たるんだったら、割のいい勝負になります。このなかだと、複勝のオッズ1倍が配当の期待値が一番大きいですけど、まーこれだと意味がなさそうでうね。
最後に念のため、期待値を。

つまり、特に他の情報がなければ、オッズが大きいのは返って期待値が低い。
感想
こんなこと思うひと少ないかもしれませんが、思ったよりもカテゴリー変数が多そうで、ポケモンと似てるなと思いました。
競艇もデータ分析の例も多いものの、回収率はいいとことんとんというところなのでしょうか?
これが、単純にいいものが無料で世に流れないだけなのか、実際に難しいかわかりませんが、面白そうなので続けたいと思います。
*1:モンキーターンの波多野憲二の3年目のSG出場はやはりめちゃはやいんですね。
*2:https://wsobv.com/boatrace/3458
*3:https://www.boatrace.jp/owpc/pc/extra/enjoy/guide/jiten/26/y_213.html
Yade (備忘録)
ここ2か月程度、個別要素法(DEM)のYadeをさわっていました。
フリーソフトとは思えないほど使いやすくマニュアルやチュートリアルもそろってるのですが、マニュアルも文良が多かったため、つまづいたところをメモします(基本的にすべて公式のマニュアルに書いてありますが...)。
使用環境
- Ubuntu
- Yade: 2020.01a
解決済み
NameError
特に使い始めは、Viewerで様子を見ながらIPythonで対話的に使うことが多いと思います。が、なぜかIPython上で、挙動が異なります。
Warning: If a function was declared inside a live yade session (ipython) and PyRunner attribute updateGlobals is set to False then an error NameError: name 'myFunction' is not defined will occur unless python globals() are updated with command:
globals().update(locals())
理解したあとも、結構めんどうです。
他にも、内包表記が苦手なのか(いつもとは限らない)、わざわざfor文で書く必要があります。
O.engines (順番)
The order of engines is important. In majority of cases, you will put any additional engine after InteractionLoop:
if it applies force, it should come before NewtonIntegrator, otherwise the force will never be effective.
if it makes use of bodies’ positions, it should also come before NewtonIntegrator, otherwise, positions at the next step will be used (this might not be critical in many cases, such as output for visualization with VTKRecorder).
O.engines (更新)
The O.engines sequence must be always assigned at once (the reason is in the fact that although engines themselves are passed by reference, the sequence is copied from c++ to Python or from Python to c++).
wrong
O.engines.append(SomeEngine()) # wrong
ok
O.engines=O.engines+[SomeEngine()] # ok
O.engines=O.engines[:2]+[SomeEngine()]+O.engines[2:]
wrong
①粒子の重力落下、②上載荷重、③やりたいこと(一面せん断とか)、とステップを踏むことがあり、途中でenginesの追加・削除を行います。
その際、条件分けしてしてると、単純な追加が面倒だったので、同じエンジンをゼロからつくってました。(なかなか気付かなかったのですが、)これだとSphere要素がFacetを貫通しはじめました。中身をみると要素同士のinteractionsが認識されていませんでした。
O.engines = O.engines+[SomeEngine()]
O.engines = O.engines[:-1]+[SameEngine()] # wrong
ok
そのようなときは、新たにEngineを定義するのではなく、前のlabelを使って以下でいけました。
O.engines = O.engines+[SomeEngine(label)]
O.engines = O.engines[:-1]+[label] # ok
上以外の壁抜け
前もって下のことが起きてたので、原因確認が難しかった。
- InsertionSortCollider忘れ
- O.dtが大きすぎ
plot.plots
これはすぐに気づきますが(dictなので)、スペースをつけないと上書きされます。
plot.plots={ 't':('val1'), 't ':['val2','val3'] }
Warning: There cannot be duplicate names declared in separate plots. This is why spaces were used above to indicate the same variable t.
変更色々
O.bodies[i].state.pos += (0,0,1) # bad for sphere
modifying the position directly is likely to break Yade’s algorithms, especially those related to collision detection and contact laws, as they are based on bodies velocities.
Facet要素を移動するのは問題ないのですが、Sphere要素だとダメでした。いったん動くのですが、次のステップでもとに戻る。なので、そのようなときは、Facet要素のみを動かして相対的な位置関係で対応させました。
O.materials[i].young /= 10**5 # bad?
密詰めしたあとに、粒子径を変更すると反発力が大きすぎて、粒子が拡散します。それをさけるために、ばね定数を一時的にさげて、徐々に大きくするのを試しましたが、どうも挙動が安定しません。これは明らめました。
一方、frictAngleはチュートリアルにもあるので、よさそうです。
# create "dense" packing by setting friction to zero initially
O.materials[0].frictionAngle = 0 # ok
メモリ関連?
pack.randomDensePack後に、O.bodies.replaceByClumpsを実行すると、要素数が多い際には以下エラーがでました。(感覚的には、自分の環境では要素数5万前後が境界)
python3.8: /usr/include/boost/smart_ptr/shared_ptr.hpp:734: typename boost::detail::sp_member_access
::type boost::shared_ptr ::operator->() const [with T = yade::Body; typename boost::detail::sp_member_access ::type = yade::Body*]: Assertion px != 0' failed. Aborted (core dumped)
O.bodies.replaceByClumpsを最後にではなく、複数にわければ問題なく実行できました。
おそらくメモリ問題だと思いますが、ここでそんなにメモリを使用してるのが意外でした。
interactions
ChatGPTに間違われてはまったところ。O.interactionsでも計算まわるのですが、.all()をつけないとなぜかすべてには回りませんでした。
count = 0
for i in O.interactions: # bad
    count += 1
print(len(O.interactions)==count) # False

for i in O.interactions.all(): # ok
    ....
未解決
force
以下のようにして、荷重をかけれます。
O.forces.addF(0,(1,0,0)) #applies for one step
O.forces.setPermF(0,(1,0,0)) #applies permanently
が、O.save()したのち、別でO.load()すると、確かにsetPermFは残ってるのですが(The permanent force on a body can be checked with O.forces.permF(id).)、明らかに挙動がおかしいことがありました。とりあえず、再度荷重をかけなおして対応してます。
threads
yade --threads=4
TriaxialTest()で試したところ、numberOfGrains=1000, Iteration=100だと、thread=1が最も速くむしろthread数を増やすと遅くなります。 一方で、numberOfGrains=10万程度だと、thread=8程度で最も速くなりました。
InsertionSortCollider()が圧倒的に時間を占めているので、もう少し理解したい。
damping
これはソフトではなくDEM自体ですが、dampingがあまり理解できてません。Yadeでは計算簡易化されているようですが、基本的には他ソフトと同じような仕組みです。
https://yade-dem.org/doc/formulation.html#numerical-damping
計算式からは毎ステップdamping forceが発生してるので、dtに依存しそうですが、実際にはdtには依存していません。
Primary view
GUIから実行した場合は、Primary viewで様子が確認できるのですが、コマンドから実行すると画面が更新してくれません。
DeepLearningによるポケモンのランクマッチの環境予測(レギュレーションH)
TL;DR
過去のランクマッチベースにレギュレーションHでの、ポケモン使用率の順位を予測した。
一般的な予想と概ね一致し、違いとしてはフリージオがワンチャンあります(希望)。
背景
前々からポケモンのランクマッチの順位を過去データから推定したいと思ってましたが、思った以上に線形回帰だとフィッティングしなかったのですが、あとで使うDeepLearningだと結局よいモデルが出たとして、中身がよくわからないとあまり嬉しくないなと思って、途中でほうり投げていました。
一方でSVが始まって2年間近くYoutube見てて、なんとなく環境の変化の意味がわかってきたような気もするし、そもそも触ってみないことにははじまらないのと、なによりも、レギュレーションHが9月から開始するということで、「いまやらないならもうやらないでしょ?」と思ったので、GW利用して一気にやってみます。
環境の評判
すでにいろんなところで、来月の環境が予想されています。基本的な理解としては、
使ったデータ
SVのランクマッチ・レギュレーションFまでの順位と、その際の情報など。
ポケモンのスペックは、種族値6+特性1+タイプ18=25個で定量化。
技は、計33個で定量化し、
- 物理/特殊、変化1個
- 威力
- 値
- 分類12個
- タイプ18個
分類は手作業ですが、'0:攻撃', '1:先制', '2:一撃', '3:バインド', '4:自分交代', '5:相手交代', '6:積み','7:状態異常', '8:デバフ', '9:設置', '10:回復', '11:その他変化'
model概要
線形回帰をする必要がなくなった(あきらめた)ので、モデルは基本的にやりたいことてんこ盛りです。
盛り込みたい要素は、
- そのポケモン以外の環境も入力にする。例えば、マニューラも強いけどその代わりのポケモンがいる(パオジアンでいいよね)/環境にささってる。とかで評価したい。
- 新たな技修得を評価したい。例えば、クイックターン修得したママンボウみたいな。
それを再現する入力要素は次の3つ。
てんこ盛りとはいいつつ、テラスタルや道具について、環境がまわったときにどう変化するかまで追うのは難しそうだったので、除外。
もしもう少し頭を使うなら、環境トップにフェアリーがいないので、、、みたいなことを考えれば、もっと簡略化した入力データになる気がしますが、特性や技については考えられないので、結局うまくいかない気がします。DeepLearningがどこまで柔軟にがんばってくれるかに期待。
とは言っても、ポケモンの分析で面倒な特性と技の追加効果について、結局数値データにする必要があるのですが、技については先制技などのフラグをつくったほかに、別途点数付けしたものを追加しました(有効かは不明)。
方法
以上のデータに対して、DeepLearingのモデルを5つ作って、Validation dataに対して一番よかったモデルを使います。*1

データ数は、トップ120匹x15シーズンx30日 ≒ 50Kくらいで、パラメータはせいぜいその1/10程度になるようにしています。
データはポケモンやシーズンを考慮せずに単純に分割して、2割を検証用に。*2
結果1
いままでのレギュレーションでの結果から、推定します。
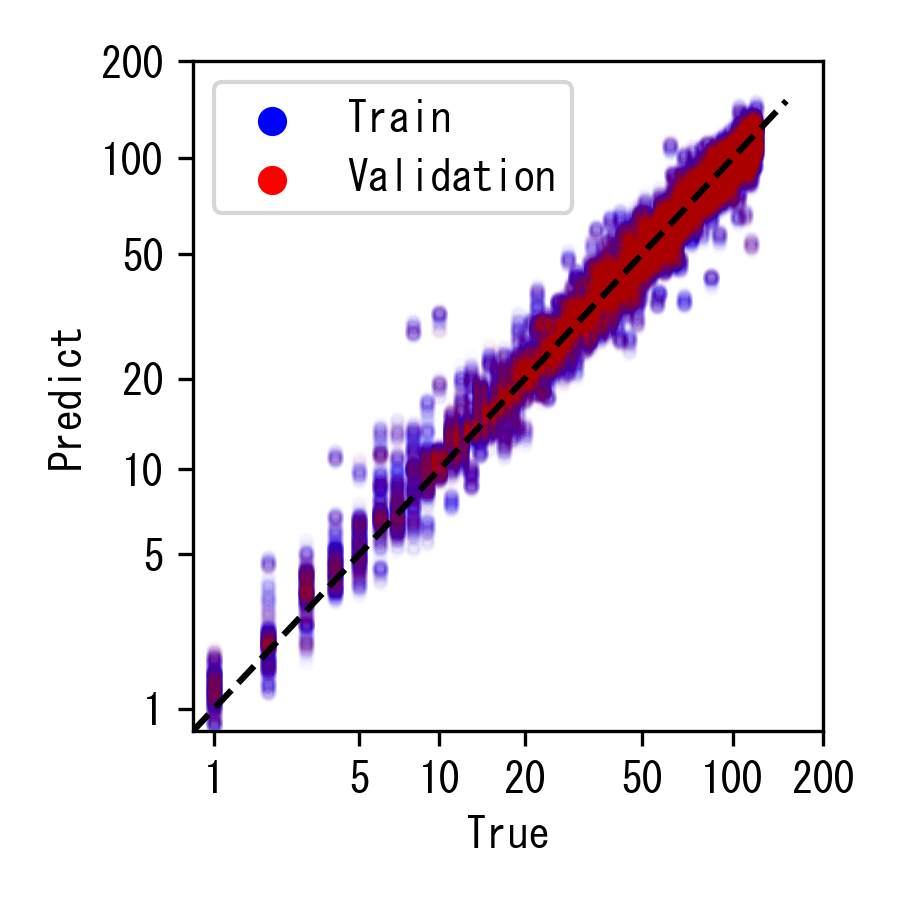
環境上位をしっかり予測してほしいので、予測値は対数順位にしてます。検証データとテストデータにほとんど差はなくできています。平均的には1.6割程度の誤差。データは当然、対数順位が大きいほうに偏りますが、ばらつきは順位にほとんど影響なさそう。
結果2
- で、そのモデルを使って、レギュレーションFの順位を最初の入力値にして、ここに含まれないものはレギュレーションAの順番で追加します。両方で150番にふくまれないものは今回は除外しました。これを仮順位とします。
- この仮順位の上位を現環境と仮定して、再度順位を予想します。
- で、当初の仮順位と比較してその違いが小さくなるまで繰り返します。
以上、これが予想30位だ(笑)

凡例は、Rank predicted. (Max rank)/Name。リージョンフォームなどで画像にずれがありますが、ご容赦ください。正しくは、ガチグマ=>あかつき、キュウコン=>アローラ、ロトム=>水ロトム。
まず、カイリュー、ガチグマ、サーフゴーがトップにきてるのはよし。よくない点は、SVの最高順位が100位に入っていないポケモンの
- フリージオ
- ケッキング
の2匹。ケッキングはとくせいのなまけが、他に比較対象がないため、評価を0置換したのが効いてるはずなので、そこの修正でなんとかしたい。
フリージオは聞いたことないが(ドータクンならあるけど)、思ったより早いSと、ふゆうが評価されたんだろうか?ワンちゃんいけるのか?
逆に有力候補で入ってこないポケモンとその予想順位は、
参考:https://altema.jp/pokemonsv/reghranking
そこまで悪くもないので、まーよいか程度。グライオンは事前評価がかなりよいので、それ次第。
改良案
というわけで、無理やりいっきに予想までやってみたが、思った以上によくできた。
改善点はしっかりみないとわからないことが多いが、上に挙げたのに加えて、今回持ち物の情報をいれてないのに、ポリ2が上位に入っているのはなぜか?とかがある。
すぐに思いつく改善案(というか時間があればやりたいこと)としては、
- 特性の点数付けについて、できなかったものは0で置換している。なにかしらの方法で追加する。明らかに上位互換の関係があれば、それらも考慮したい。ケッキングとかのマイナスの特性は最低値にするとか?
- ポケモンと技のタイプを全18タイプにしてクラス分けしているが、技の効果については考慮していない。技の範囲を同じような入力にしたほうが、わかりやすいかもしれない(が、一部に特性によるのがあるため、面倒)。
- 技を上位6個にしてるが、もう少し丁寧に。技範囲やタイプ一致をもっと明確に示してもよいかも。
- Sを種族値にしてるが、環境のなかの順位にする。
- アイテムを考慮する。例えば、しんかのきせきなら、実数値に換算して、種族値をふやす(ただし、他のアイテムは不明)
- レギュレーションHに環境が一番近いレギュレーションAの日ごとのデータが出てないので、少なくなっている。最終日の順位を少し前後させて、合成データを作ってもよいかも。
- データを無理やり増やす。例えば、物理ポケモンでCの種族値を10,20下げても大きく影響ないので、それで増やす(これだけで数倍になる)。他にも、すべてのSをあげる、HACをあげるとか。
- SVだけのデータを使ったが、SWSH以前もつかってみる(ただし、ダイマ他をどう考慮するか不明)。やはり上で無理やりデータ増やすより、いろんな環境に対応したほうがよさそう。
奇跡的に、フリージオ環境入りしてくれないかな。
感想
計算をまわすたび、徐々に環境が変わっていく様子を期待していたのですが、計算初回にして6位のフリージオまではその後に変化ありませんでした。
推定結果が次の入力に使われるのは、誤差がつもりつもっていくので難しい反面、面白い方法なのでなんとかしたいが、とりあえずレギュレーションHの1期が終わったら、結果と照らし合わせてみようかなー。
それで良さそうなら、パーティー評価を試してみたい。ただ入力とパラメータ数が確実に増えるのに対し、データ数が減るのをどうやって対処するか。
学会開催地の地域差:沖縄でやってくれないかな
多くの学会が年に1度程度の頻度で学術講演会を実施しています。 最近暑いので、北海道かいっそ沖縄いきたいなー、と思ったら、「観光地のほうがその手の会議の参加者多いんじゃね?」と思ったので、ものは試しに調べてみた。
結論からすると、場合による。 ただやはり場所の違いは多くて2割くらいありそう。
- Google検索ですぐに開催年と参加者数がわかる
- 比較的規模の大きい学会
- 比較的歴史のある学会
を条件に、日本看護科学学会と土木学会の2つを調べました。
https://www.jans.or.jp/modules/meetings/index.php?content_id=3
https://committees.jsce.or.jp/zenkoku/node/52


日本看護科学学会は圧倒的に東京開催が多かったので、東京のみでフィッティングしてます。逆に、土木学会は東京と北海道で少し外れてそうだったので、東京と北海道以外でフィッティングしています。カーネルには、線形とMatern52(適当)を使ってます。期間中に10倍程度人数変化していて、対数モデルのほうがあてはまりがよさそうだったので、そちらで。土木学会は戦前から開催されてるが、ばらつき具合がちがそうだったので、1963年から(ついでにコロナ前まで)。
凡例には両学会で何個かあった代表例として、北海道、東京、大阪、広島、福岡を利用。
データ選定はかなり適当です。例えば、日本看護科学学会は参加人数に対して、土木学会は講演数。土木学会なら違いは薄い印象だが、どうだろう?講演数なら投稿は講演会よりもかなり前だから、例えば台風とかのイレギュラーの影響をうけなさそうだが、調べていない。看護学会の参加人数は延べなんだろうか?看護学会でトレンドよりかなり多い参加なのは埼玉(95年)開催なので、東京のみでなく関東のくくりのほうがよいかも。いずれにしろ、地域性をもっと丁寧に定量化したほうがよさそう。
日本看護科学学会は北海道だといつもより2割程度参加者が少ないのに対し、土木学会だと逆に1割程度多い。土木学会は当初の予想通りだったんだけど、むしろ看護学会で北海道では逆転してる。
すぐに思ったのは、看護学会だと土日開催なので、1泊で会議に参加するのに、北海道だとむしろ強行軍になってつらいのかなー、てところ。それ以外にも学会のメインの参加者が大学関係者か企業かなどの違いがあるかもしれません。
| 日本看護科学学会 | 土木学会 | |
|---|---|---|
| 開催時期 | 12月 | 9月 |
| 期間 | 2日(土日) | 3日(おおむね平日) |
けっこう面白いけど、観光関連で誰か調べてないかな?
国際会議も興味あるけど、どこから行くかも重要そうだしな。
雑記
カーネルにLinear()要素いれたけど、うまく機能していなそう。
